บทนำ
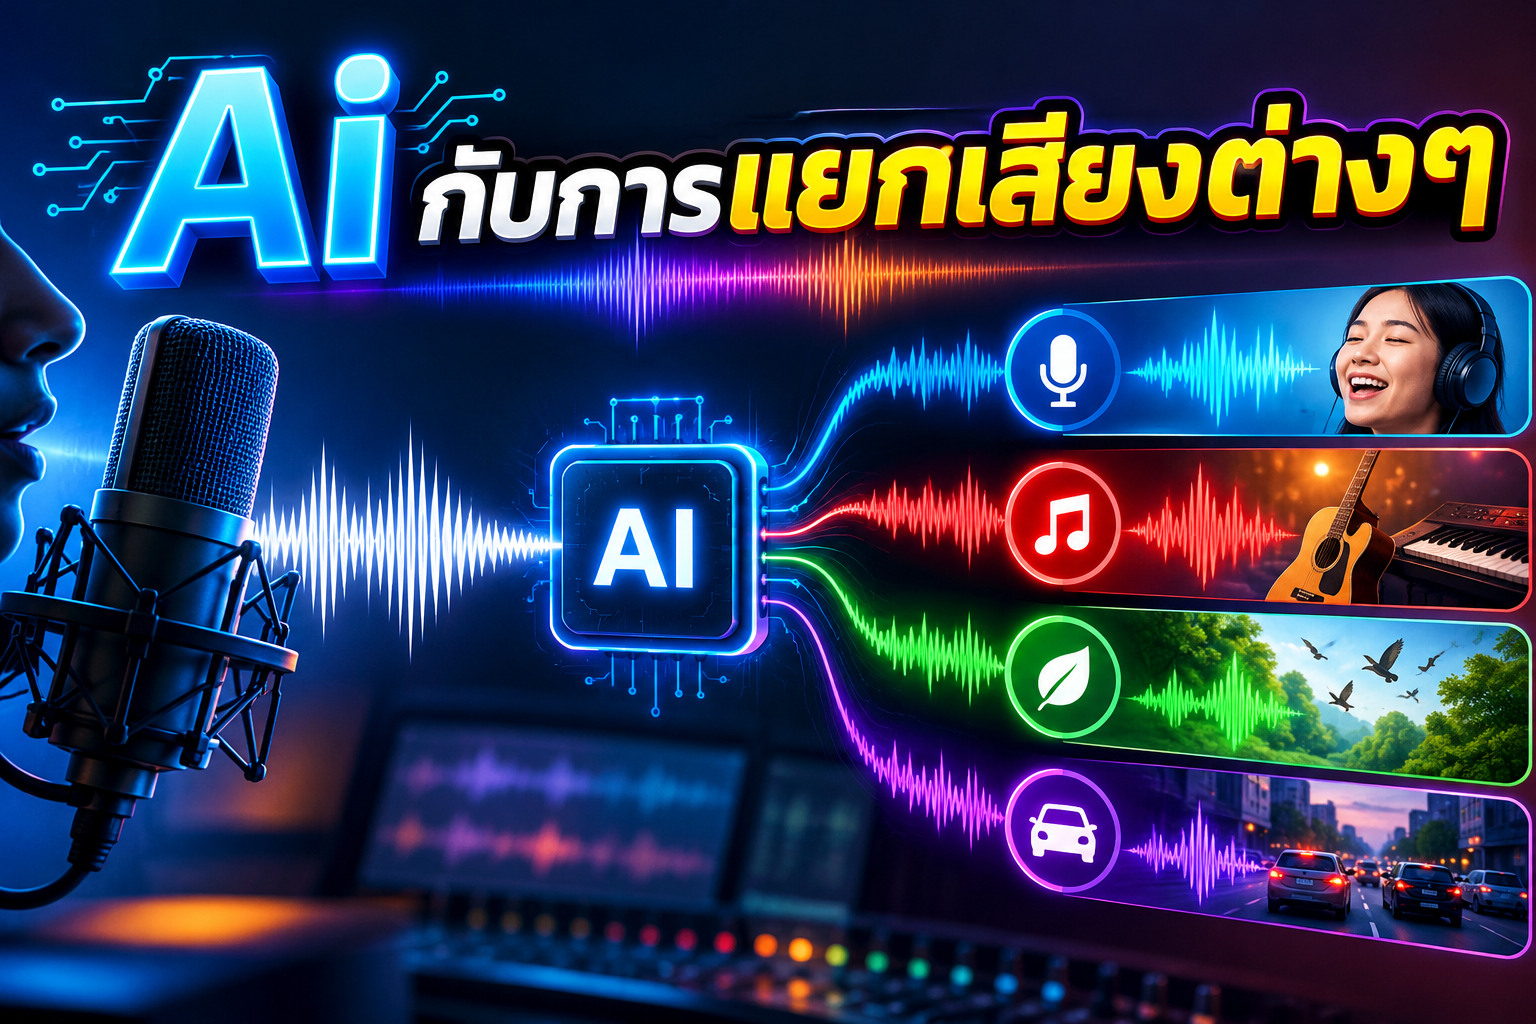
ในยุคที่เทคโนโลยีปัญญาประดิษฐ์ หรือ Artificial Intelligence (AI) เข้ามามีบทบาทในชีวิตประจำวันมากขึ้น หนึ่งในความสามารถที่น่าสนใจของ AI คือ การแยกเสียงต่าง ๆ (Audio Source Separation) ซึ่งเป็นเทคโนโลยีที่ช่วยให้คอมพิวเตอร์สามารถวิเคราะห์ จำแนก และแยกเสียงที่ผสมกันอยู่ในไฟล์เสียงเดียวออกจากกันได้ เช่น การแยกเสียงพูดออกจากเสียงรบกวน การแยกเสียงร้องออกจากดนตรี หรือการแยกเสียงเครื่องดนตรีแต่ละชนิดออกจากบทเพลง
เทคโนโลยีนี้กำลังเปลี่ยนวิธีการทำงานในหลายวงการ ไม่ว่าจะเป็นอุตสาหกรรมดนตรี การผลิตภาพยนตร์ การสื่อสาร การแพทย์ และระบบรักษาความปลอดภัย ทำให้การจัดการเสียงมีความแม่นยำ สะดวก และมีประสิทธิภาพมากยิ่งขึ้น
1. AI กับการแยกเสียงคืออะไร?
การแยกเสียงด้วย AI คือกระบวนการนำปัญญาประดิษฐ์มาวิเคราะห์สัญญาณเสียงที่ประกอบด้วยแหล่งกำเนิดเสียงหลายประเภท แล้วแยกเสียงเหล่านั้นออกเป็นส่วน ๆ ตามลักษณะหรือแหล่งกำเนิด
ตัวอย่างเช่น เมื่อเราบันทึกเสียงสนทนาในร้านกาแฟ ไฟล์เสียงอาจประกอบด้วยเสียงพูดของคน เสียงเพลง เสียงเครื่องชงกาแฟ และเสียงผู้คนรอบข้าง AI สามารถช่วยแยกเสียงพูดที่ต้องการออกจากเสียงรบกวนอื่น ๆ เพื่อให้ได้เสียงสนทนาที่ชัดเจนขึ้น
เทคโนโลยีที่เกี่ยวข้องแบ่งออกเป็นหลายประเภท ได้แก่
- Speech Separation: การแยกเสียงพูดของบุคคลหลายคนที่พูดพร้อมกัน
- Speech Enhancement: การปรับปรุงคุณภาพเสียงพูดและลดเสียงรบกวน
- Music Source Separation: การแยกเสียงร้อง เสียงกลอง เสียงเบส และเครื่องดนตรีอื่น ๆ
- Sound Event Detection: การตรวจจับและจำแนกเหตุการณ์เสียง เช่น เสียงสุนัขเห่า เสียงไซเรน หรือเสียงกระจกแตก
- Speaker Diarization: การวิเคราะห์ว่าใครเป็นผู้พูดในแต่ละช่วงเวลาของการสนทนา
แม้เทคโนโลยีเหล่านี้จะเกี่ยวข้องกับการวิเคราะห์เสียงเหมือนกัน แต่มีวัตถุประสงค์และวิธีการทำงานแตกต่างกัน
2. AI แยกเสียงต่าง ๆ ได้อย่างไร?
เบื้องหลังความสามารถในการแยกเสียงของ AI คือเทคโนโลยี Machine Learning และ Deep Learning ซึ่งช่วยให้คอมพิวเตอร์เรียนรู้รูปแบบของเสียงจากข้อมูลจำนวนมาก
กระบวนการทำงานโดยทั่วไปประกอบด้วย 4 ขั้นตอนสำคัญ
ขั้นตอนที่ 1 การรับสัญญาณเสียง
ระบบรับข้อมูลเสียงจากไมโครโฟน ไฟล์เสียง หรืออุปกรณ์บันทึกเสียง ซึ่งอาจมีเสียงหลายประเภทผสมกันอยู่
ขั้นตอนที่ 2 การวิเคราะห์ลักษณะเสียง
AI วิเคราะห์คุณสมบัติของสัญญาณ เช่น ความถี่ ความดัง จังหวะ และรูปแบบการเปลี่ยนแปลงของเสียง บางระบบใช้การแปลงสัญญาณเสียงเป็นภาพสเปกโตรแกรม (Spectrogram) เพื่อช่วยวิเคราะห์ข้อมูลในมิติของเวลาและความถี่ ขณะที่บางระบบประมวลผลคลื่นเสียงโดยตรง
ขั้นตอนที่ 3 การแยกแหล่งกำเนิดเสียง
โมเดล AI ที่ผ่านการฝึกฝนจะประเมินว่าส่วนใดของสัญญาณเป็นเสียงพูด เสียงดนตรี หรือเสียงจากแหล่งกำเนิดอื่น จากนั้นสร้างสัญญาณเสียงแยกตามประเภทที่ต้องการ
ขั้นตอนที่ 4 การสร้างไฟล์เสียงใหม่
ระบบนำผลลัพธ์มาสร้างเป็นไฟล์เสียงแยก เช่น ไฟล์เสียงร้อง ไฟล์เสียงดนตรี หรือไฟล์เสียงพูดที่ลดเสียงรบกวนแล้ว เพื่อนำไปใช้งานต่อ
อย่างไรก็ตาม คุณภาพของผลลัพธ์ขึ้นอยู่กับความซับซ้อนของเสียง คุณภาพไฟล์ต้นฉบับ และความสามารถของโมเดล AI
3. ตัวอย่างการนำ AI มาใช้แยกเสียง
3.1 การแยกเสียงร้องออกจากเพลง
หนึ่งในการใช้งานที่ได้รับความนิยมคือการแยกเสียงร้องของนักร้องออกจากเสียงเครื่องดนตรี ทำให้สามารถสร้างเพลงสำหรับคาราโอเกะ หรือแยกเสียงร้องเพื่อนำไปใช้ในกระบวนการผลิตเพลงได้
ตัวอย่างเครื่องมือที่เกี่ยวข้อง ได้แก่ Demucs, Spleeter และ Moises ซึ่งมีความสามารถในการแยกองค์ประกอบของเพลง โดยรายละเอียดและคุณภาพการแยกเสียงแตกต่างกันตามเครื่องมือและรุ่นของโมเดล
3.2 การแยกเสียงพูดออกจากเสียงรบกวน
AI สามารถช่วยลดเสียงลม เสียงพัดลม เสียงรถยนต์ และเสียงพื้นหลังระหว่างการประชุมออนไลน์หรือการบันทึกเสียง
เทคโนโลยีนี้มีประโยชน์สำหรับผู้ผลิตพอดแคสต์ นักข่าว ผู้สร้างคอนเทนต์ และผู้ที่ต้องทำงานในสภาพแวดล้อมที่มีเสียงรบกวน
3.3 การแยกเสียงของผู้พูดหลายคน
เมื่อมีผู้พูดหลายคนพร้อมกัน AI บางระบบสามารถแยกเสียงของแต่ละบุคคลออกจากกันได้ ช่วยให้การถอดเสียงประชุมหรือการวิเคราะห์บทสนทนามีประสิทธิภาพมากขึ้น
อย่างไรก็ตาม การแยกเสียงผู้พูดที่ซ้อนทับกันยังเป็นงานที่ท้าทาย โดยเฉพาะเมื่อเสียงมีลักษณะคล้ายกันหรือบันทึกด้วยไมโครโฟนคุณภาพต่ำ
3.4 การตรวจจับเสียงผิดปกติ
AI สามารถเรียนรู้ลักษณะเสียงของเครื่องจักรและตรวจจับเสียงที่อาจบ่งบอกถึงความผิดปกติ เช่น เสียงเสียดสี เสียงกระแทก หรือเสียงมอเตอร์ที่เปลี่ยนไป
การประยุกต์ใช้นี้ช่วยสนับสนุนระบบบำรุงรักษาเชิงคาดการณ์ในโรงงานอุตสาหกรรม และลดความเสี่ยงจากความเสียหายของเครื่องจักร
4. เทคโนโลยี AI ที่ใช้ในการแยกเสียง
โมเดลและเทคนิคสำคัญที่เกี่ยวข้องกับการแยกเสียงมีหลายประเภท เช่น
Deep Neural Networks (DNNs)
โครงข่ายประสาทเทียมเชิงลึกสามารถเรียนรู้ความสัมพันธ์ที่ซับซ้อนของสัญญาณเสียง และช่วยประมาณองค์ประกอบเสียงจากแหล่งกำเนิดต่าง ๆ
Convolutional Neural Networks (CNNs)
โมเดลประเภทนี้สามารถวิเคราะห์รูปแบบของข้อมูลเสียง โดยเฉพาะข้อมูลที่แสดงในรูปสเปกโตรแกรม เพื่อเรียนรู้ลักษณะเฉพาะของเสียงแต่ละประเภท
Transformer Models
เทคโนโลยี Transformer ใช้กลไก Attention เพื่อวิเคราะห์ความสัมพันธ์ของข้อมูลเสียงในช่วงเวลาต่าง ๆ และถูกนำไปใช้ในงานประมวลผลเสียงสมัยใหม่
Hybrid Audio Models
โมเดลบางประเภทผสมผสานการประมวลผลคลื่นเสียงโดยตรงกับการวิเคราะห์ข้อมูลในโดเมนความถี่ เพื่อเพิ่มประสิทธิภาพในการแยกองค์ประกอบของเสียง
5. ประโยชน์ของ AI ในการแยกเสียง
การใช้ AI แยกเสียงช่วยสร้างประโยชน์ในหลายด้าน ได้แก่
- เพิ่มคุณภาพเสียง: ลดเสียงรบกวนและทำให้เสียงที่ต้องการชัดเจนขึ้น
- ประหยัดเวลาในการทำงาน: ลดขั้นตอนการแก้ไขเสียงด้วยตนเอง
- สนับสนุนงานสร้างสรรค์: ช่วยนักดนตรี โปรดิวเซอร์ และผู้ผลิตวิดีโอจัดการเสียงได้สะดวกขึ้น
- เพิ่มประสิทธิภาพการสื่อสาร: ช่วยให้การประชุมออนไลน์และการบันทึกเสียงพูดมีคุณภาพดีขึ้น
- พัฒนาระบบอัตโนมัติ: สนับสนุนการตรวจจับเหตุการณ์เสียงและการวิเคราะห์เสียงในระบบอัจฉริยะ
- ส่งเสริมการเข้าถึงข้อมูล: ช่วยปรับปรุงเสียงพูดสำหรับการถอดเสียงและการสร้างคำบรรยาย
6. ข้อจำกัดและความท้าทาย
แม้ AI จะสามารถแยกเสียงได้อย่างมีประสิทธิภาพ แต่ยังมีข้อจำกัดบางประการ
ความแม่นยำของการแยกเสียง
หากเสียงหลายชนิดมีความถี่ใกล้เคียงกัน หรือเกิดขึ้นพร้อมกันในระดับที่ซับซ้อน AI อาจแยกเสียงได้ไม่สมบูรณ์
คุณภาพของไฟล์ต้นฉบับ
ไฟล์เสียงที่มีความละเอียดต่ำ มีการบีบอัดสูง หรือมีเสียงรบกวนมาก อาจทำให้ผลลัพธ์มีคุณภาพลดลง
การเกิดเสียงผิดเพี้ยน
บางครั้งระบบอาจทำให้เสียงบางส่วนหายไป หรือสร้างสิ่งแปลกปลอมทางเสียง (Audio Artifacts) หลังการประมวลผล
ประเด็นด้านลิขสิทธิ์และความเป็นส่วนตัว
การนำเสียงของผู้อื่นมาแยก ดัดแปลง หรือเผยแพร่ ควรคำนึงถึงสิทธิของเจ้าของผลงาน ความยินยอม และกฎหมายที่เกี่ยวข้อง โดยเฉพาะเสียงพูดที่มีข้อมูลส่วนบุคคล
7. อนาคตของ AI กับการแยกเสียง
ในอนาคต เทคโนโลยี AI ด้านเสียงมีแนวโน้มพัฒนาไปสู่การประมวลผลที่รวดเร็วและแม่นยำยิ่งขึ้น โดยเฉพาะระบบที่สามารถทำงานแบบเรียลไทม์
ตัวอย่างการประยุกต์ใช้ที่น่าสนใจ ได้แก่
- หูฟังอัจฉริยะที่ช่วยเน้นเสียงพูดของบุคคลที่ต้องการฟัง
- ระบบประชุมออนไลน์ที่แยกเสียงผู้พูดหลายคนได้ดีขึ้น
- โปรแกรมตัดต่อวิดีโอที่สามารถเลือกปรับเสียงแต่ละองค์ประกอบได้อย่างอิสระ
- ระบบตรวจจับเสียงอันตรายในบ้านอัจฉริยะ
- ระบบช่วยฟังที่ปรับเสียงตามสภาพแวดล้อมและความต้องการของผู้ใช้งาน
นอกจากนี้ การพัฒนาโมเดล AI ที่มีขนาดเล็กลงยังอาจทำให้เทคโนโลยีแยกเสียงทำงานบนสมาร์ตโฟน หูฟัง และอุปกรณ์พกพาได้มากขึ้น โดยไม่จำเป็นต้องส่งข้อมูลทั้งหมดไปประมวลผลบนระบบคลาวด์
8. สรุป
AI กับการแยกเสียงต่าง ๆ เป็นเทคโนโลยีที่มีบทบาทสำคัญต่อการพัฒนาระบบประมวลผลเสียงในยุคดิจิทัล จากเดิมที่การแยกเสียงต้องอาศัยผู้เชี่ยวชาญและเครื่องมือเฉพาะทาง ปัจจุบัน AI ช่วยให้ผู้ใช้งานทั่วไปสามารถจัดการเสียงที่ซับซ้อนได้ง่ายขึ้น
ไม่ว่าจะเป็นการแยกเสียงร้องจากเพลง การลดเสียงรบกวน การแยกเสียงผู้พูด หรือการตรวจจับเสียงผิดปกติ ล้วนเป็นตัวอย่างที่แสดงให้เห็นถึงศักยภาพของปัญญาประดิษฐ์
แม้เทคโนโลยีนี้ยังมีข้อจำกัดด้านความแม่นยำและคุณภาพของผลลัพธ์ แต่ด้วยการพัฒนาอย่างต่อเนื่อง AI มีแนวโน้มที่จะกลายเป็นเครื่องมือสำคัญในอุตสาหกรรมเสียง การสื่อสาร และระบบอัจฉริยะในอนาคต
ท้ายที่สุด AI ไม่ได้เพียงช่วยให้เราได้ยินเสียงชัดเจนขึ้น แต่ยังช่วยให้คอมพิวเตอร์สามารถวิเคราะห์และเข้าใจองค์ประกอบของโลกแห่งเสียงได้อย่างลึกซึ้งมากยิ่งขึ้น